
你的编程助手的训练数据截止于你的依赖最新版本发布之前,所以它可能写出你锁定的版本已经不再接受的调用。since-cutoff 指出你的代码在哪里用到了在模型训练截止日期之后发生变化的 API,并写出简短的说明,帮助你的助手避开旧写法。
since-cutoff 是一个面向 Python 项目的命令行工具和 MCP 服务器。scan 读取你的 lockfile,为每个依赖默认取你的编程模型训练截止日期至少 30 天之前发布的最新版本,静态地把这个版本的公开 API 与你锁定的版本对比,并指出你的代码用到了哪些有变更的 API、在哪里用到,为每个 API 给出一条说明。sync 把这些说明写进 AGENTS.md 或 CLAUDE.md,并让它们与 lockfile 保持同步;说明过时时,status、pre-commit 钩子和 GitHub Action 会提醒你。run(可选)测量你的模型实际会写错哪些变更,以及这些说明是否有用。只有 run 会调用模型。


English | 简体中文 | Español | Français
需要 Python 3.10 或更高版本,支持 Linux、macOS 和 Windows。
pipx install since-cutoff # 或:pip install since-cutoff也可以不安装直接运行:uvx since-cutoff scan 会下载当前版本并运行(uvx since-cutoff@latest scan 会使用新发布的版本,而不是 uv 第一次缓存的那个)。
run 用 basedpyright 对模型的回答做类型检查,这是一个 180 MB 的 extra,其他命令都用不到:pip install "since-cutoff[run]"(或 pipx install "since-cutoff[run]")会安装它,uvx --with basedpyright since-cutoff run 则不用安装就能在这次运行中加上它;没有它时,run 会立即停止并说明原因。
请在项目根目录运行。它会读取 uv.lock、poetry.lock、pdm.lock、pylock.toml、Pipfile.lock、requirements*.txt、pyproject.toml、Pipfile、conda environment.yml 的 pip: 部分或 .venv(不读取 setup.py 和 setup.cfg)。不加 --model 时,它使用你的编程 Agent 所配置的模型,从 Claude Code、Codex、Gemini CLI、OpenCode 或 Aider 的设置中读取;要使用其他模型,请传入 --model(见选择模型)。scan、sync 和 status 不调用模型,也不需要 API key;run 会把提示词发送给模型服务商,消耗你的 API 额度或 Claude Code 用量。
在编程 Agent 中,可以由技能替你运行这些命令:见在 Claude Code 中使用和在其他编程 Agent 中使用。MCP 服务器把同样的对比结果提供给任意 Agent。
示例项目调用了 client.messages.create,并锁定 anthropic 1.8.0。在 Claude Sonnet 4.5 的训练截止日期,anthropic 的最新版本是 0.60.0,它的 create 还接受 temperature;1.8.0 遇到这个参数会抛出 TypeError。scan 的输出(只保留 anthropic 部分;它从 0.56.0 开始对比,即截止日期前 30 天发布的最新版本:模型对截止日期前几周的了解最少):
$ uvx since-cutoff scan --model anthropic:claude-sonnet-4-5
Your code uses 2 APIs that changed after claude-sonnet-4-5's training cutoff (2025-07-31)

huggingface-hub 0.33.1 -> 2.0.0 (0.33.1 was the latest release 30 days before the cutoff;
  pyproject.toml pins 2.0.0)
  ...

anthropic 0.56.0 -> 1.8.0 (0.56.0 was the latest release 30 days before the cutoff; pyproject.toml
  pins 1.8.0)
  Messages.create: temperature, top_k and top_p were removed                          uses this API
    app/main.py   calls create
    Note: `Messages.create()` no longer accepts `temperature`, `top_k` or `top_p` as keyword
          arguments. If the API still needs them, pass them through its `extra_body` argument.
          [diff]

2 notes ready: `since-cutoff sync` writes them to AGENTS.md and keeps them in step with
  pyproject.toml.
app/main.py 中的调用没有传这些参数中的任何一个,所以被标为“uses this API”(用到了这个 API),而不是“old form”(旧写法):它现在能正常运行,但一个按 0.60.0 写代码的助手在修改这个调用时,可能会加上 temperature=0.2。这条说明就是 since-cutoff sync 写进 AGENTS.md、用来防止这种情况的内容;它的标签 [diff] 表明了它的依据:对两个版本公开 API 的静态对比。参数从函数签名中移除,并不等于 API 不再接受这个字段;所以当锁定版本的方法带有 extra_body 参数时,说明会指出这一点,而不是让助手删掉这个字段。
接着,since-cutoff sync 写入这两条说明。它以 diff 的形式显示区块,并询问 Write this to AGENTS.md? [y/N](--yes 不询问直接写入;--dry-run 只显示 diff)。对于示例项目,区块的结尾是:
**anthropic 1.8.0** (compared from 0.56.0)
- `Messages.create()` no longer accepts `temperature`, `top_k` or `top_p` as keyword arguments. If the API still needs them, pass them through its `extra_body` argument. [diff]

**huggingface-hub 2.0.0** (compared from 0.33.1)
- `huggingface_hub.hf_hub_download()` no longer accepts `proxies`, `force_filename`, `local_dir_use_symlinks` or `resume_download`; do not pass them. huggingface-hub's deprecation text says there is no replacement for `force_filename`, `local_dir_use_symlinks` or `resume_download`. For `proxies`, see https://github.com/huggingface/huggingface_hub/releases (2.0.0). [diff]
<!-- since-cutoff:end -->
在这些条目之上是开始标记、一行元数据(模型、它的截止日期、版本的来源、依赖的哈希值,以及区块自身文本的哈希值,这样手动修改就能被发现),以及一段开头说明:写明模型、截止日期和版本来自哪个文件,解释各个标签的含义,并说明没有运行任何库的代码。整个区块约 410 个 token。区块以外的文本逐字节保持不变,since-cutoff unapply 可以移除这个区块。升级依赖后再运行一次 sync;CI 中的 sync --check 和离线的 status 会在说明过时时提醒你(见用 sync 和 status 保持说明最新)。
在你的项目上试试。 不需要 API key,不调用模型。在项目根目录运行:
uvx since-cutoff scan它会检测你的编程模型(也可以用 --model 指定),读取你的 lockfile,为每个依赖默认取模型训练截止日期至少 30 天之前发布的最新版本,并静态地把这个版本的公开 API 与你锁定的版本对比:不运行任何包代码。截止日期只用来决定看哪些变更,并不代表模型记住了什么。你的模型是否真的会写错这些 API、说明是否有用,由 since-cutoff run 来测量;它会调用你的模型,是可选的。
如果你用编程 Agent 写 Python,并且锁定的依赖在模型训练截止日期之后发布过新版本,就适合用它;在 Python AI 生态中,大多数库都是这样(见问题是什么):
- 用
scan看一眼:你的代码用到的有变更的 API、在哪里用到,每个附一条说明; - 用
sync把说明写进 AGENTS.md 或 CLAUDE.md 并保持最新,用sync --check、status、pre-commit 钩子或 GitHub Action 在说明过时时得到提醒; - 用 MCP 服务器让 Agent 在写代码之前先问一下某个库改了什么;
- 用
run弄清你的模型是否真的会写旧 API,以及说明能否纠正它。
它不做的事:
- 调用模型(
run除外):scan、sync、status、MCP 服务器、Action 和钩子都不需要 API key; - 运行包代码或模型写的代码:包只被静态读取,回答只经过类型检查;
- 发现函数签名不变但行为改变的情况,以及只在运行时发出警告的弃用;
- 给出替代写法,除非库自己的弃用文本中写明了替代写法;
- 断言模型记住了什么:截止日期只用来选对比版本,只有
run会去问模型; - 改写你的代码:要迁移已有代码,codemod 才是合适的工具(见与其他工具的比较);
- 支持其他语言:目前只支持 Python,TypeScript 见 #1;它给出的是文件名,不是行号(#8)。
完整列表见局限。
每个模型都有训练截止日期,而你的 lockfile 一直在更新。一个库在截止日期之后改了公开 API,训练数据早于这次变更的模型仍可能按旧版本的写法调用。这样的代码有些会在导入或调用时报错;有些还能运行,因为旧写法只是被标记为弃用,或者仍被接受并发出警告。
下面是 since-cutoff scan 针对 Claude Sonnet 4.5(训练截止 2025 年 7 月)在示例项目中找到的部分变更。这个项目的 9 个依赖中有 6 个锁定在当前版本,另外 3 个没有锁定(工具使用它们的最新版本):
| 库 | 截止日期时的版本 | 锁定版本 | 变了什么 |
|---|---|---|---|
| anthropic | 0.60.0 | 1.8.0 | messages.create(temperature=..., top_p=..., top_k=...) 不再被接受 |
| huggingface-hub | 0.34.3 | 2.0.0 | hf_hub_download(resume_download=..., force_filename=..., local_dir_use_symlinks=...) 这些参数在 1.0 中已从函数签名里去掉(2.0.0 在运行时仍接受它们,但会忽略并发出警告) |
| langchain-core | 0.3.72 | 1.6.5 | retriever.get_relevant_documents() 和 llm.predict() 已移除 |
| openai | 1.98.0 | 3.19.2 | 19 个破坏性变更,6 个新的弃用(另有 3 个内部 API 变更) |
在这个项目中,9 个依赖里有 7 个在截止日期之后改了公开 API。静态对比共标出公开 API 的 257 个破坏性变更和 23 个新的弃用,以及内部 API 的 71 个变更;项目代码用到了其中 2 个有变更的 API。
这不是某一个模型或某一家厂商的问题。在 36 个常用的 Python AI 库和来自 OpenAI、Anthropic、Google、xAI、DeepSeek、Qwen、Moonshot、Mistral 的 21 个模型上,即使是测试中最新的模型(Claude Opus 5.5,训练截止 2026 年 6 月),这 36 个库里也有 20 个在它的截止日期之后发生了公开 API 的破坏性变更(完整结果,英文):

since-cutoff 针对这个问题做三件事:
scan:为每个依赖找出默认在模型截止日期至少 30 天之前发布的最新版本,把它的公开 API 与你锁定的版本做对比,并指出你的代码用到了哪些有变更的 API、在哪里用到,为每个 API 给出一条说明。不调用模型,不需要 API key。sync:先给你看 diff,再把这些说明写进 AGENTS.md(或 CLAUDE.md)中一个带标记的区块,并让它们与你的 lockfile 保持同步;说明过时时,sync --check和status会提醒 CI、pre-commit 和你的 Agent。每条说明都根据 API 对比结果写成,并带有一个标签,表明检查了什么。不调用模型。run(可选):在不给工具、不给文档的情况下,让模型完成需要用到这些变更 API 的简短编程任务,再用类型检查器针对两个版本分别给每个回答打分:过时(stale)、写错(wrong)、已弃用(deprecated)或正确(correct)。全程没有 LLM 当评判。它为每个失败项写一条说明;模型写的说明只有在其中的示例能通过你所用版本的类型检查时才保留;然后在留出任务(held-out)上,分别在无说明和有说明的情况下重新测试模型。
同样的对比结果也通过 MCP 服务器提供给 Agent,通过 GitHub Action 和 pre-commit 钩子提供给 CI。下面的讲解视频(英文)用两分半钟概括了这一节。
# 你的代码用到的、有变更的 API,每个附一条说明(不调用模型,不需要 API key)
uvx since-cutoff scan

# 把这些说明写进 AGENTS.md(先显示 diff 并征求确认);升级依赖后再运行一次
uvx since-cutoff sync

# 可选:测出你的模型会写错哪些变更,并测试这些说明(会调用模型;
# --with 会加上只有 run 需要的 basedpyright 类型检查器)
uvx --with basedpyright since-cutoff run
scan 在示例项目上的完整输出:
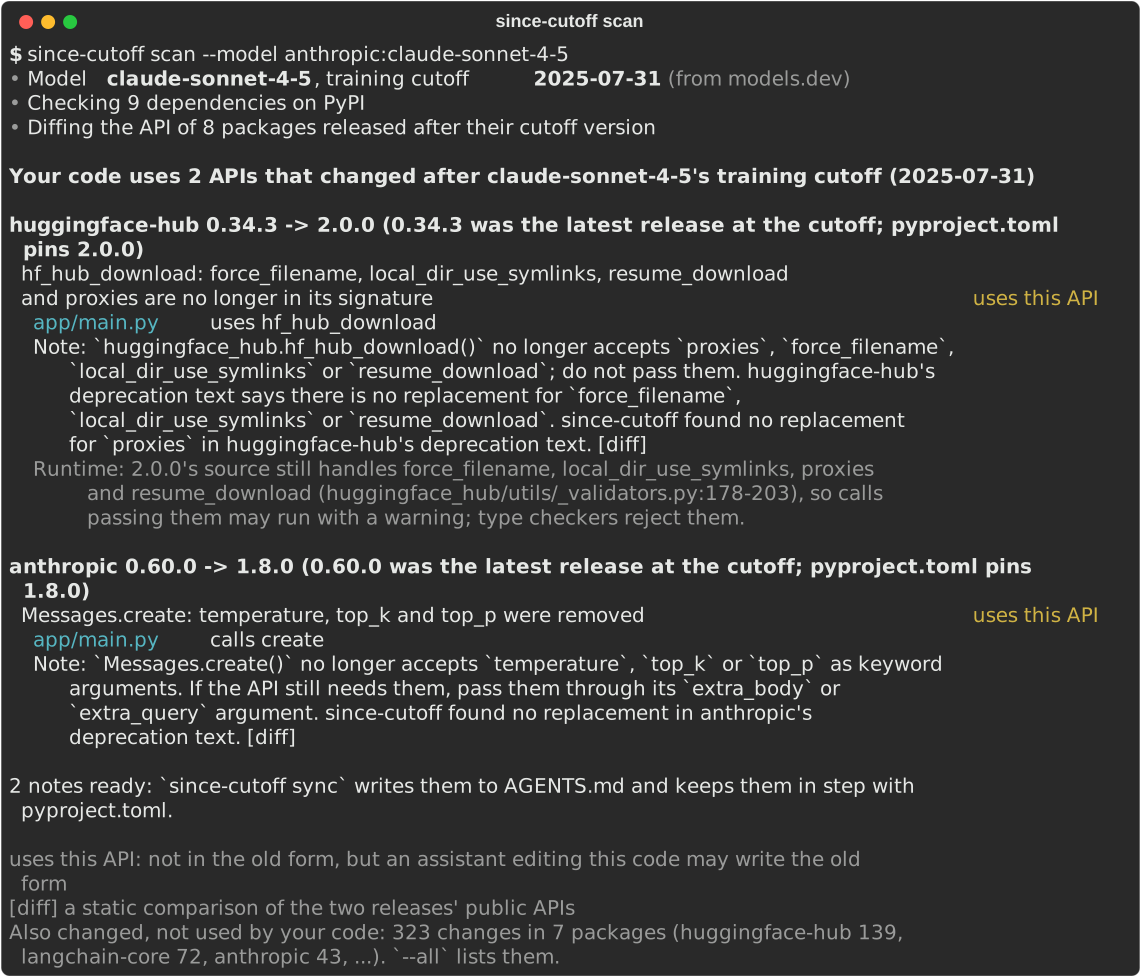
这两个 API 都是“uses this API”;如果某个文件传了 resume_download=True 或 temperature=0.2,它们就会变成“old form”。scan -v 列出用到某个 API 的所有文件(默认显示 3 个),scan --all 会逐个包列出公共 API 的其余所有变更(--internal 再加上内部 API 的变更,各项计数把它们单独记为“+N internal”)。scan --json 和 .since-cutoff/results.json 的 used_apis 中有同样的内容(每个 API、用到它的位置、它的变更和说明,以及说明的标签、适用的版本和检查了什么),.since-cutoff/report.md 以“Used by your code”开头。
since-cutoff sync(0.4.0 及以后)把 scan 显示的说明写进一个带标记的区块:写在 AGENTS.md 中;只有 CLAUDE.md 时写在 CLAUDE.md 中;CLAUDE.md 没有导入 AGENTS.md 时两个文件都写;已经有区块的,就更新那个区块(--target 可以指定其他文件)。它会显示一个统一格式的 diff,并询问 Write this to AGENTS.md? [y/N];--yes 不询问直接写入;没有可以询问的终端时,它什么也不写。区块以外的文本逐字节保持不变(包括 CRLF 换行),since-cutoff unapply 可以移除这个区块。示例项目的区块见快速开始。“Runtime:”这条提示不写进区块:无论如何,建议(“do not pass them”,不要传这些参数)都是一样的。
修改 lockfile 或代码之后,再运行一次 sync。它会为代码新用到的 API 添加说明,重新检查升级过的包;当某个包不再是依赖、不再比对照版本新,或者你的代码不再用到它有变更的 API 时,删除这个包的说明,并说明原因。它会沿用区块写入时的模型和截止日期(这样,Agent 使用其他模型的同事就不会来回改写它),除非你传入 --model 或 --cutoff;--model a,b 取它们中最早的截止日期。没有任何变化时,它什么也不写,文件的字节和修改时间都保持不变。
| 命令 | 作用 | 退出码 |
|---|---|---|
since-cutoff sync |
显示 diff,询问后写入 | 0 已写入或已是最新;3 未写入(你回答了否,或没有可以询问的终端) |
since-cutoff sync --yes |
不询问直接写入 | 0 |
since-cutoff sync --dry-run |
显示 diff,不写入任何内容 | 0 |
since-cutoff sync --check |
不写入任何内容(用于 CI 和 pre-commit) | 0 已是最新;3 已过时 |
since-cutoff sync --json --yes |
不询问直接写入;以 JSON 输出提议和写入结果 | 与 sync --yes 相同 |
since-cutoff sync --json --check |
以 JSON 输出提议;不写入任何内容 | 0 已是最新;3 已过时 |
since-cutoff sync --json --dry-run |
以 JSON 输出提议;不写入任何内容 | 0 |
since-cutoff status |
离线比较区块与 lockfile | 0 已是最新,或没有区块;3 已过时;1 标记损坏 |
区块被手动修改过时,sync 和 sync --check 会显示 diff,不写入任何内容,并以退出码 4 结束;sync --force 会替换它。说明所涉及的某个包无法检查时(例如 PyPI 无法访问),sync 不写入任何内容,并以退出码 1 结束。
sync --json 需要搭配 --yes、--check 或 --dry-run;缺少其中之一时,它不询问,直接以退出码 2 结束。标准输出只包含 JSON;sync 失败时标准输出为空(用法错误,退出码 2;或其他错误,例如无法访问 PyPI,退出码 1);进度、diff 和错误都输出到 stderr。对象包含 exit_code、tip(sync 关于 AGENTS.md 和 CLAUDE.md 的提示,没有时为 null)和 targets。每个目标文件报告 target、action、changed、edited、written、model、cutoff、scope、notes、changes(每个包的 package、done 和 state)、retest 和 diff_lines。written 用来区分已应用的提议、预览和被拒绝的手动修改。通常的退出码和 --force 的行为仍然适用。
since-cutoff status 不联网,也不读取代码:它列出每个包的说明所对应的版本和 lockfile 中的版本、其他依赖是否有变化,以及你的编程 Agent 所配置的模型的训练截止日期是否早于说明所用的截止日期(并给出相应的 sync --model 命令)。status --json 供脚本使用。status --hook 只在说明过时时输出一行,并且总是以 0 退出,例如:
since-cutoff: the library notes in AGENTS.md are out of date: anthropic 1.8.0 in the notes, 0.60.0 in pyproject.toml. `since-cutoff sync` updates them.
更多选项:
sync --scope imported还会为你的代码导入的每个有变更的包,写出最可能有影响的那些变更的说明(每个包最多 5 个 API),适用于还没有用到任何有变更 API 的代码。遇到这种情况时,scan会提示这个选项。sync --suggestions会加上锁定版本中那些只是与被移除内容相似的名称,并标为[not confirmed]。区块会记录这两个选择,之后的 sync 会沿用它们。since-cutoff run --apply写入的说明带有[type-checked]标签。只要它所在的包版本不变、你的代码仍在用那个 API,sync就会保留它,代替同一 API 由 diff 得出的说明。
Claude Code 会读取 CLAUDE.md;只有在没有 CLAUDE.md,或者 CLAUDE.md 用一行 @AGENTS.md 导入了 AGENTS.md 时,才会读取 AGENTS.md(记忆文档,英文);Codex、Cursor 和 Copilot 读取 AGENTS.md。两个文件都在、还没有说明块时,如果 CLAUDE.md 导入了 AGENTS.md,说明只写进 AGENTS.md;没有导入时,两个文件都写(#13),scan、sync 和 status 会说明怎样只保留一份:在 CLAUDE.md 中加一行 @AGENTS.md,再运行 since-cutoff unapply --target CLAUDE.md。已经只在 AGENTS.md 中的说明块会留在那里;CLAUDE.md 没有导入它时,它们会给出提示。两个文件都有说明块、之后 CLAUDE.md 又导入了 AGENTS.md 时,它们会提示 CLAUDE.md 中是第二份副本,并给出同样的 unapply 命令。代码片段或代码块中的 @AGENTS.md 不算导入。
since-cutoff run 是会调用模型的可选步骤。它让模型完成需要用到这些变更 API 的简短任务(不给工具、不给文档,也不包含你的任何代码),用类型检查器针对两个版本给回答打分,为每个失败项写一条说明,并在留出任务上测试这些说明(见工作原理)。它会消耗你的 API 额度或 Claude Code 用量,可能需要 5-20 分钟。
since-cutoff run --quick    # 较小规模的运行:12 个探测、1 个留出任务、3 个回归检查
since-cutoff run --apply    # 把这次运行的说明写进区块
不加 --apply 时,说明只显示、不写入。run --apply 会用这次运行的说明替换区块;之后再运行 since-cutoff sync,会为你的代码用到的其他有变更 API 加上由 diff 得出的说明,并在对应包的版本不变时保留这次运行的 [type-checked] 说明。
/plugin marketplace add MohammadHijjawi97/since-cutoff
/plugin install since-cutoff@since-cutoff
然后让 Claude“检查一下你对我们哪些依赖的了解已经过时了”,或者运行 /since-cutoff:since-cutoff。技能会运行 since-cutoff scan,并提出写入说明:它先运行 since-cutoff sync --dry-run,给你看 diff,只有在你同意后才写入。如果你让它测试模型,测量由一个全新的、不带任何工具的模型副本完成,所以 Agent 没法给自己打分。插件还会启动 MCP 服务器,这样 Claude 可以在写代码之前先查一下某个库改了什么;并且(0.4.0 及以后)在每次会话开始时运行 since-cutoff status --hook,在说明过时时向会话添加一行提示(第一次运行时,uvx 会下载 since-cutoff)。
npx skills add MohammadHijjawi97/since-cutoff这条命令通过开源的 skills 命令行工具,把同一个技能安装到 Codex、Cursor、Gemini CLI、GitHub Copilot、OpenCode 以及其他读取 SKILL.md 的 Agent 中。since-cutoff 也会从 Codex、Gemini CLI、OpenCode 和 Aider 的设置中读取模型;对于其他 Agent,需要告诉它要使用哪个模型,例如 since-cutoff scan --model openai:gpt-5.4。然后按下文的方法添加 MCP 服务器。
效果较好的提示词:
- “我们的代码用到的哪些 API 在你的训练截止日期之后发生了变化?”Agent 会运行
since-cutoff scan或调用 MCP 工具project_changes。 - “把关于它们的说明加到 AGENTS.md。”Agent 会运行
since-cutoff sync --dry-run,给你看 diff,在你同意后运行since-cutoff sync --yes。 - “测一下你实际会写错其中哪些变更。”Agent 会先征求你的同意,再运行
since-cutoff run --quick。 - “写 httpx 代码之前,先查一下 httpx 在你的截止日期之后改了什么。”Agent 会调用 MCP 工具
api_changes。
--model |
使用 | 需要 |
|---|---|---|
claude-code(没有任何设置指定模型时的默认值) |
你的 Claude Code 登录(订阅或 API key),当前模型 | claude 命令行工具 |
claude-code:sonnet、claude-code:claude-haiku-4-5 |
指定的 Claude 模型 | claude 命令行工具 |
anthropic:<model> |
Anthropic API | ANTHROPIC_API_KEY |
openai:<model> |
OpenAI API | OPENAI_API_KEY |
openrouter:<vendor/model> |
OpenRouter | OPENROUTER_API_KEY |
deepseek:<model> |
DeepSeek API | DEEPSEEK_API_KEY |
ollama:<model> |
本地 Ollama | 正在运行的 Ollama |
openai-compatible:<model> |
任何 OpenAI 兼容的服务 | --base-url,可选 OPENAI_API_KEY |
“需要”一列是针对 run 的,因为它会调用模型;scan 和 sync 只用模型的训练截止日期。不加 --model 时,0.3.0 及以后的版本会使用你的编程 Agent 所配置的模型,并在模型那一行注明来源(“model from .claude/settings.json”):
SINCE_CUTOFF_MODEL(完整写法,例如openai:gpt-5.4)始终优先。- 在 Claude Code 内部运行时(Claude Code 会为它执行的命令设置
CLAUDECODE=1),只看 Claude Code 自己的设置:先是ANTHROPIC_MODEL,然后是项目的.claude/settings.local.json和.claude/settings.json,最后是~/.claude/settings.json。 - 在其他环境中,以最具体的设置为准:先是
ANTHROPIC_MODEL、GEMINI_MODEL或AIDER_MODEL;然后是项目设置,从被扫描的目录向上查找到仓库根目录,离得最近的目录优先(不包括主目录及其上层目录);最后是用户设置。在同一个目录中,各 Agent 按下表的顺序计算:
| Agent | 项目设置 | 用户设置 |
|---|---|---|
| Claude Code | .claude/settings.local.json、.claude/settings.json |
~/.claude/settings.json |
| Codex | .codex/config.toml,包括其中选定的 profile |
$CODEX_HOME/config.toml 或 ~/.codex/config.toml |
| Gemini CLI | .gemini/settings.json |
~/.gemini/settings.json |
| OpenCode | opencode.json、opencode.jsonc |
~/.config/opencode/ |
| Aider | .aider.conf.yml,支持 Aider 的别名(4o、flash、r1 等) |
~/.aider.conf.yml |
如果没有任何设置指定模型,它会使用 Claude Code 的默认模型,并明确说明这一点。它只读取这些文件中的模型字段;遇到无法识别的模型名称时会停止运行,并在提示中指出是哪个设置。Agent 通过其他服务(GitHub Copilot、Amazon Bedrock、Vertex AI)使用的模型,会按开发它的厂商来命名,因此 run 调用的是该厂商的 API(openai: 需要 OPENAI_API_KEY)。sync 会沿用区块写入时的模型,不管你的 Agent 现在用的是哪个。
训练截止日期来自 models.dev(内置一份快照,可离线使用)。since-cutoff models sonnet 可以列出这些日期(--makers 不列出网关和转售商,--json 供脚本使用)。多个服务商收录的模型,采用所请求服务商条目的截止日期(opencode:glm-5.1);没有时采用其制造商的条目;再没有时,采用网关或转售商所列的最早截止日期:说明更多,更稳妥。模型行会写出不属于制造商的条目,since-cutoff models <id> 的最后一行会写出 --model <id> 采用的条目。--cutoff 2025-07 可以覆盖截止日期;不加 --model 运行 since-cutoff scan --cutoff 2025-07,则只按这个日期扫描。--cutoff-margin 30(默认值;也可以用 SINCE_CUTOFF_CUTOFF_MARGIN 设置)从截止日期前 30 天或更早发布的最新版本开始对比,因为模型对截止日期前几周的了解最少;--cutoff-margin 0 则从截止日期当天的最新版本开始对比。模型行会同时显示这两个日期。scan 和 sync 只需要训练截止日期,所以也接受不带服务商的模型 id(claude-haiku-4-5、sonnet),以及带有 models.dev 收录的任一服务商前缀的模型 id(例如 google:gemini-2.5-pro,也包括 Amazon Bedrock 和 Vertex AI 的 id);run 则需要上表中的服务商。
训练截止日期是不是模型从那天起就对某个库一无所知的日期? 不是。since-cutoff 只用截止日期来选一个对比点:对每个依赖,默认取那一天至少 30 天之前发布的最新版本,再把它的公开 API 与你锁定的版本对比(--cutoff-margin 0 恢复原来的行为:取截止日期当天或之前发布的最新版本)。模型对截止日期前几个月的内容掌握得不好,也可能知道截止日期之后发布的版本,所以扫描结果可能列出模型本来就会用对的变更,也可能漏掉它会写错的变更。模型是否会写旧 API,由 run 来测量。日期来自 models.dev;since-cutoff models <名称> 会把每个模型的截止日期和发布日期并排列出,两者相差数月(claude-sonnet-4-5:截止 2025-07-31,发布于 2025-09-29)。详见训练截止日期的用途。
什么内容会被发送到哪里? scan、sync、status、MCP 服务器、GitHub Action 和 pre-commit 钩子只读取 PyPI(元数据和 wheel 文件)和 models.dev,不向任何模型发送任何内容。run 会向你选择的模型服务商发送提示词:包名、版本、有变更 API 的公开签名和文档字符串、生成的任务,以及(为了写说明)模型自己的回答;绝不会发送你的源代码。哪些文件用到了有变更的 API,会显示在终端和 .since-cutoff/ 中,只有你主动发送时才会传到别处:用 --markdown 生成的 CI 摘要,或调用了 MCP 工具 project_changes 的 Agent。没有遥测。详见它会运行、发送和保存什么和 PRIVACY.md(英文)。
为什么有些说明写着“since-cutoff found no replacement”? 只有当库自己的弃用文本写明了替代写法、且这个名称存在于你锁定的版本中时,说明才会给出替代写法(标签 [diff + library])。否则,说明陈述变更,并给出该包的变更日志(其 PyPI 元数据中的 Changelog 链接,否则是它在 GitHub 上的 releases 页面)和锁定的版本;PyPI 两者都没有列出时,才指出没有找到替代写法:猜出来的替代写法会被 Agent 照着用,比不给更糟。锁定版本中那些只是名字相似的内容,会在终端中以“not confirmed as replacements”显示;sync --suggestions 会把它们写进说明,标为 [not confirmed]。当锁定版本的方法仍带有 extra_body 参数时(例如 anthropic 的 Messages.create()),说明会指出这一点,因为从签名中移除的请求参数可能仍被 API 接受。
写进 AGENTS.md 还是 CLAUDE.md? sync 写进 AGENTS.md;只有 CLAUDE.md 时写进 CLAUDE.md;CLAUDE.md 没有导入 AGENTS.md 时两个文件都写(#13);两者中已经有区块的,就写进那个(--target 可以指定任意文件)。Claude Code 读取 CLAUDE.md,只有当 CLAUDE.md 用一行 @AGENTS.md 导入了 AGENTS.md 时才会读取 AGENTS.md;Codex、Cursor 和 Copilot 读取 AGENTS.md。要只保留一份,就在 CLAUDE.md 中加上 @AGENTS.md,再运行 since-cutoff unapply --target CLAUDE.md;两个文件都有区块时,scan、sync 和 status 会提示这一点,只在 AGENTS.md 中的区块没有被导入时也会提示。此后 sync 会更新每个有区块的文件,status 也会逐个报告。
这些说明要花多少 token? Agent 每一轮都会读取这个区块。对示例项目来说,区块约 410 个 token,其中两条说明约 140 个;其余是开头说明,写明模型和截止日期并解释各个标签(按每 4 个字符一个 token 计算,与 since-cutoff 自己的算法一致)。sync 只为你的代码用到的有变更 API 写说明(--scope imported 为每个导入的包最多再加 5 条),模型写的说明最多 60 个英文单词。在基准测试中,区块在 285 到 505 个 token 之间,带说明的会话消耗的总 token 数是不带说明的 0.73 倍。run 会报告每个区块的 token 数。
能离线用吗? status 完全不访问网络。scan 和 sync 需要从 PyPI 获取每个包的版本列表(缓存 12 小时;PyPI 无法访问时,使用更早的缓存副本,并在输出中说明它是哪一天的),以及每个有变更的包的源码;源码和对比结果都会缓存,所以之后的运行只需几秒。训练截止日期来自 models.dev,并内置一份快照供离线使用。
目前测到的结果,各自注明范围:
- 一个项目、一个模型、since-cutoff 0.1.0:下面的卡片,Claude Opus 4.6 在示例项目上的结果。卡片后面的表格加上了 Claude Haiku 4.5 在同一项目上的结果。
- 基准测试:360 次无头模式的 Claude Code 会话(
claude-opus-5-5),24 个带隐藏测试的 Python 任务,协议在正式运行之前冻结。在 17 个训练截止日期之后发生变更的任务上,配合 since-cutoff 0.4.1 的说明时,成本是单独使用 Claude Code 的 0.80 倍(95% CI 0.70-0.90),轮数是 0.83 倍,耗时是 0.87 倍。不对通过率下结论:单独使用的 Claude Code 已经通过了其中 94.1% 的任务,高于预先注册的 90% 天花板阈值。Context7 的几组没有使用 API key,从 360 次会话中的第 215 次起只收到“Monthly quota exceeded”,这不影响说明与单独使用之间的对比。仅一个模型、一个 Agent:结果(英文),任务、协议和会话记录。 - 独立开发者的报告:会列在这里,每份都注明项目、模型和日期。欢迎把你的报告发到 Share your results。

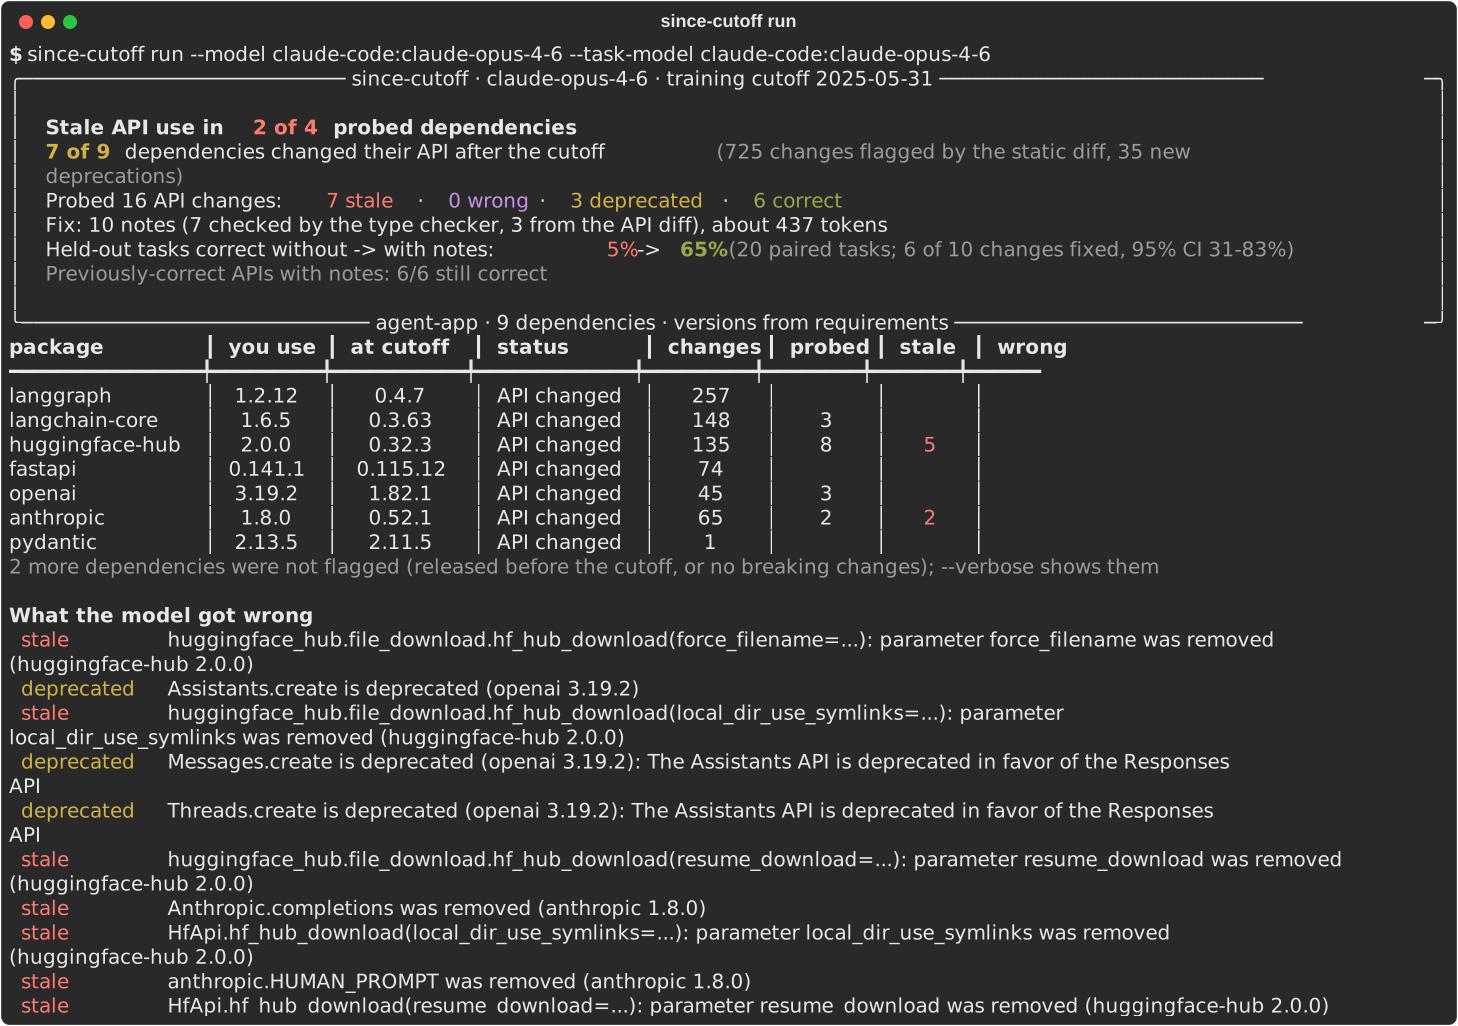
两个 Claude 模型在 examples/agent-app 这个有 9 个依赖的示例项目上的结果,用 since-cutoff 0.1.0 测得,任务和说明由 Claude Opus 4.6 编写:
| Claude Haiku 4.5 | Claude Opus 4.6 | |
|---|---|---|
| 训练截止 | 2025 年 2 月 | 2025 年 5 月 |
| 探测的 API 变更 | 20 | 16 |
| 过时 / 写错 / 已弃用 / 正确 | 5 / 1 / 2 / 12 | 7 / 0 / 3 / 6 |
| 出现过时用法的库 | 探测的 5 个中有 3 个 | 探测的 4 个中有 2 个 |
| 写出的说明(其中示例能通过类型检查的) | 8 条(7 条),约 391 token | 10 条(7 条),约 437 token |
| 留出任务正确率:无说明 -> 有说明 | 14% -> 57%(14 对) | 5% -> 65%(20 对) |
| 原本答对的 API 在加入说明后 | 6/6 仍正确 | 6/6 仍正确 |
留出任务是对每个失败变更的探测任务的改写;每个任务回答两次,一次不带说明,一次带说明,用同样的方式打分。最后一行重新检查模型原本就答对的 API,用来发现会起反作用的说明。
在这个样本中,更强的模型并没有更可靠:Opus 4.6 写出了在它截止日期之后已被移除的 API,例如 anthropic.HUMAN_PROMPT 配合 client.completions。两次运行中出现的过时代码(每一处都在对照版本上有效,在锁定版本上无法通过类型检查):messages.create(temperature=...)(anthropic 1.8),hf_hub_download(resume_download=...)、local_dir_use_symlinks=...、force_filename=... 和 proxies=...(huggingface-hub 2.0),以及 client.beta.vector_stores(openai 3.x)。在运行时,anthropic 1.8.0 遇到 temperature 会抛出 TypeError;huggingface-hub 2.0.0 仍接受这四个下载参数,但会忽略它们并发出警告。
Claude Haiku 4.5 那次运行写出的说明(节选,原文照录;since-cutoff 0.1.0 的格式):
<!-- since-cutoff:start -->
## Library changes after the model's training cutoff

**anthropic 1.8.0**
- `temperature=...` was removed from `messages.create()` in anthropic 1.8.0. Omit the `temperature` parameter entirely; there is no replacement.

**huggingface-hub 2.0.0**
- `hf_hub_download(..., resume_download=True)`: The `resume_download` parameter was removed in huggingface-hub 2.0.0. Omit it; downloads resume automatically.

**openai 3.19.2**
- `client.beta.vector_stores` is removed in openai 3.19.2. Use `client.vector_stores` instead.
<!-- since-cutoff:end -->
huggingface-hub 那条说明并不完全准确:resume_download 是在 1.0 而不是 2.0.0 中从函数签名里去掉的,而且 2.0.0 在运行时仍接受它,只是忽略它并发出警告(源码)。不过“省略它”这个建议仍然是对的。0.4.0 根据 API 对比结果为这几个参数写出的说明见快速开始;关于运行时的提示出现在终端、报告和 JSON 中,不在区块里。
下图是 Claude Opus 4.6 那次运行的终端摘要,用 0.1.0 录制。探测结果与上表一致。卡片上的对比数量是 0.1.0 的数字(“725 changes flagged”);对比逻辑修正之后,0.2.0 的 scan 对同一截止日期报告 513 个破坏性变更和 48 个新的弃用。卡片上的“changes fixed”数量及其 95% 置信区间也是 0.1.0 的算法:这个区间属于这个数量,而不是 5% -> 65% 这两个比率;而且 0.2.0 及更早的版本即使某个留出任务在没有说明时就已经答对,也会把该变更算作已修复。
Claude Haiku 4.5 那次运行的同样摘要(同样用 0.1.0;0.2.0 的 scan 对它的截止日期报告 491 个破坏性变更和 50 个新的弃用)
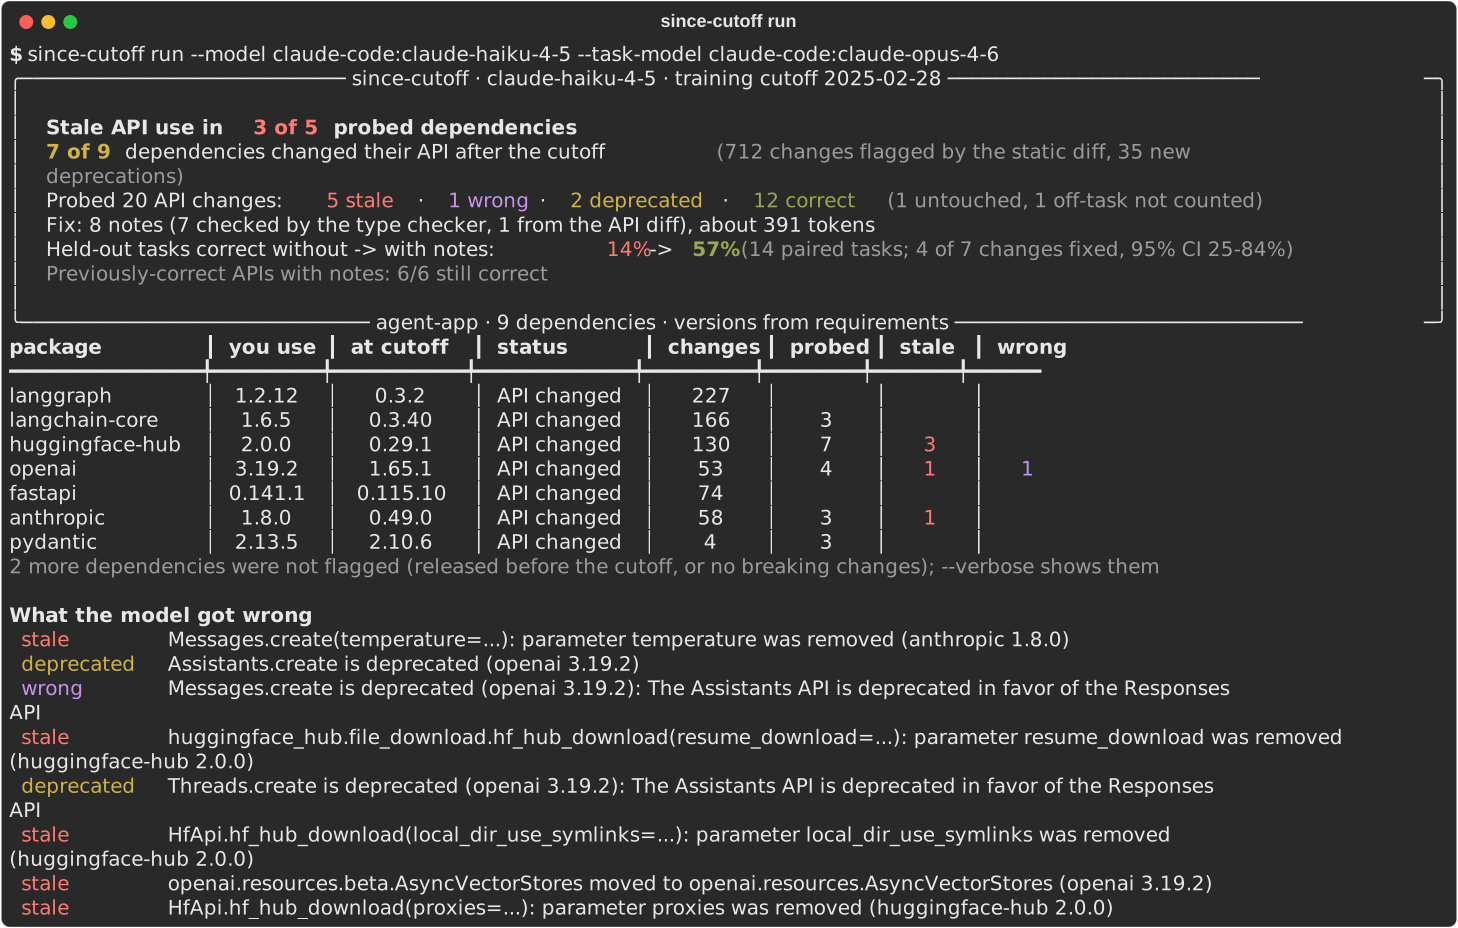
样本小,只有两个模型、一个项目:请把它当作方法的演示,而不是基准测试。每次运行都会把完整报告(每个任务、每个回答和每条类型检查错误)写入 .since-cutoff/report.md。用当前版本重复这个实验(它的对比和排序都有变化,所以探测不会完全相同):cd examples/agent-app && since-cutoff run --model claude-code:claude-haiku-4-5 --task-model claude-code:claude-opus-4-6。从 0.3.0 起,还能保存一次运行所用的任务:加上 --tasks-out tasks.json,其他人就可以用 --tasks-from tasks.json 在完全相同的任务上重复这次运行,换一个模型或换一组说明都可以。这个文件记录了任务的编写者(模型、提示词版本和 since-cutoff 版本),在复用的任务上运行时也会在报告中注明(详情,英文)。非常欢迎把你自己项目上的结果发到 Share your results。
测量方法的细节,以及这些数字能说明什么、不能说明什么,见这篇文章(英文)。
since-cutoff mcp 是一个 MCP 服务器,让编程 Agent 可以在写代码之前先问一句“这个库在我的训练截止日期之后改了什么?”。它提供三个只读工具:
| 工具 | 回答什么 |
|---|---|
api_changes(package, model, symbol=...) |
一个库从默认在模型截止日期至少 30 天之前发布的版本到最新(或指定)版本之间改了什么,破坏性变更排在最前 |
project_changes(project_dir, model) |
对项目的每个依赖按锁定版本做同样的检查,从你的代码用到的有变更 API 开始:每个 API 列出用到它的文件(最多 3 个)、它的说明、运行时提示,以及相似但未确认为替代项的名称 |
model_cutoff(model) |
模型的训练截止日期,来自 models.dev |
Agent 传入自己的模型 id,所以结果涵盖的是这个模型训练截止日期之后的变更。这些工具只静态读取 PyPI 和包的源码:不调用模型,不需要 API key,不执行任何包代码。
Claude Code
claude mcp add --scope user since-cutoff -- uvx since-cutoff@latest mcpCodex(~/.codex/config.toml)
[mcp_servers.since-cutoff]
command = "uvx"
args = ["since-cutoff@latest", "mcp"]
startup_timeout_sec = 60
tool_timeout_sec = 900Cursor(~/.cursor/mcp.json)和 Claude Desktop(claude_desktop_config.json)
{
  "mcpServers": {
    "since-cutoff": { "command": "uvx", "args": ["since-cutoff@latest", "mcp"] }
  }
}
VS Code(.vscode/mcp.json)
{
  "servers": {
    "since-cutoff": { "type": "stdio", "command": "uvx", "args": ["since-cutoff@latest", "mcp"] }
  }
}
Gemini CLI
gemini mcp add --scope user since-cutoff uvx since-cutoff@latest mcp
# 或者安装为扩展,启动的是同一个服务器:
gemini extensions install https://github.com/MohammadHijjawi97/since-cutoff
@latest 让 uvx 使用新发布的版本,而不是一直复用第一次缓存的版本(插件自带的 .mcp.json 固定到确切版本)。如果客户端找不到 uvx,请安装 uv,或者写上完整路径(which uvx)。这个服务器已登记在 MCP Registry 中,名称为 io.github.MohammadHijjawi97/since-cutoff。
在较大的项目上,第一次调用 project_changes 会下载每个有变更的依赖的 wheel,可能需要几分钟(transformers 这类特别大的包最慢)。结果会被缓存,之后的调用只需几秒。要预热缓存,可以先在项目里运行一次 since-cutoff scan,它和服务器共用同一个缓存。默认工具超时较短的客户端可能需要把超时调长,就像上面的 Codex 示例那样。project_changes 的回答会控制在约 24,000 个字符以内:放不下的有变更的依赖每个只占一行,把它们传入 only 就能列出它们的变更。
api_changes("huggingface-hub", model="claude-haiku-4-5", to_version="2.0.0") 的返回结果(真实输出,有删节):
# huggingface-hub 0.29.1 -> 2.0.0

- From 0.29.1 (2025-02-20): the newest release on or before 2025-02-28 (training cutoff of claude-haiku-4-5, from models.dev)
- To 2.0.0 (2026-09-24): as requested
- Warning: huggingface-hub 2.0.0: huggingface_hub.hf_file_system.HfFileSystemFile inherits from fsspec.spec.AbstractBufferedFile, which since-cutoff did not read; the attributes it sets are not compared
- 98 breaking changes, 0 new deprecations (dependencies switched 1, removed or moved 45, parameters removed 43, parameters now required 7, changed kind 1, now keyword-only or positional-only 1, +8 internal)

## Dependencies switched

- huggingface-hub requires `httpx2` instead of `requests`; its Requires-Dist lists `httpx2<3,>=2.0.0`, and `requests` only for its `gradio` extra; 6 places in its public API that named `requests` types name `httpx2` types: `get_session()` returns `httpx2.Client`, `HfHubHTTPError(response=...)` takes `httpx2.Response` and `HfFileSystemStreamFile.response` is `httpx2.Response`; `InferenceTimeoutError`, `HfHubHTTPError` and `TextGenerationError` derive from `httpx2.HTTPError` instead of `requests.HTTPError`

## Removed or moved

- `huggingface_hub.InferenceApi` was removed
...

## Parameters removed

- `huggingface_hub.InferenceClient.text_generation(stop_sequences=...)`: parameter `stop_sequences` was removed; the old docs said: Deprecated argument. Use `stop` instead; also changed under 1 other path, e.g. `huggingface_hub.AsyncInferenceClient.text_generation`
...
- `huggingface_hub.snapshot_download(proxies=...)`: parameter `proxies` was removed; 2.0.0's source still handles `proxies` (huggingface_hub/utils/_validators.py:178), so calls passing it may run with a warning; type checkers reject it
...

Not listed: 58 breaking changes, 0 new deprecations (removed or moved 30, parameters removed 28). Narrow with symbol="..." or raise limit.
加上 symbol="hf_hub_download" 后,只列出这个函数的 8 个变更(resume_download=、force_filename=、local_dir_use_symlinks= 和 proxies=,分别出现在该函数和 HfApi 上)。symbol 也可以按代码里的调用写法传入:client.messages.create 会找到 Messages.create 的变更。这个对比读取的是签名:这四个参数在 huggingface-hub 1.0 中已从签名里去掉,回答中还会补充说明 2.0.0 的源码仍会处理它们,所以传入它们的调用可能会带着警告运行。
在每个 pull request 上扫描项目,并在任务页面添加一份摘要:你的代码用到的有变更 API,包括用到它们的文件、变更内容、是否是旧写法和替代项;然后是折叠起来的说明和每个依赖的变更。设置 check-notes: true 时,如果 AGENTS.md 中的说明已过时,它还会让任务失败。和 scan 一样,它只读取 PyPI 和 models.dev:不调用模型,不需要 API key。
# .github/workflows/since-cutoff.yml
name: since-cutoff
on:
  pull_request:
    paths: ["**/*.lock", "**/pylock*.toml", "**/requirements*.txt", "**/environment.y*ml", "**/pyproject.toml", "**/AGENTS.md", "**/CLAUDE.md"]
jobs:
  scan:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: MohammadHijjawi97/since-cutoff@v0
        with:
          model: anthropic:claude-sonnet-4-5  # 团队写代码用的模型
          check-notes: true                   # AGENTS.md 需要 `since-cutoff sync` 时让任务失败
不设置 paths 时,代码改动开始用到有变更的 API 时也会运行这个任务。
| 输入 | 默认值 | 说明 |
|---|---|---|
model |
必填 | 格式与 --model 相同(provider:model);只用到它的训练截止日期 |
working-directory |
. |
项目目录 |
only、exclude |
逗号分隔的 PyPI 包名 | |
cutoff |
覆盖训练截止日期(YYYY-MM 或 YYYY-MM-DD) |
|
cutoff-margin |
从截止日期前这么多天发布的最新版本开始对比(since-cutoff 的默认值是 30;0 表示从截止日期当天算起) |
|
fail-on-changes |
false |
有依赖在截止日期之后改了 API 时,让这一步失败 |
check-notes |
false |
同时运行 since-cutoff sync --check(不写入任何内容),当 AGENTS.md / CLAUDE.md 中的说明已过时或区块被手动修改过时,让任务失败;说明沿用写入时的模型,model(和 cutoff)用于还没有区块的项目 |
step-summary |
true |
把 Markdown 摘要加到任务摘要(job summary)中 |
cache |
true |
在多次运行之间保留 PyPI 元数据、包源码和 API 对比结果(fail-on-changes 让任务失败时也会保留) |
args |
额外的 since-cutoff scan 参数,例如 --all-deps --limit 20 |
|
since-cutoff-version |
0.5.0 |
要运行的 since-cutoff 版本,或 latest |
args: --fail-on old-form --annotate github 只在你的代码以旧写法用到有变更的 API 时让任务失败,并为每个用到这类 API 的文件添加注解:旧写法为警告(warning),其他情况为提示(notice)。
输出:changed-packages(逗号分隔)、changes(破坏性变更数)、deprecations、markdown(摘要文件的路径,例如可用来把摘要发成 pull request 评论)、report(完整报告的路径),以及设置 check-notes 时的 notes(up-to-date、out-of-date、edited-by-hand 或 error)。能通过多个导入路径访问的同一个变更只计一次。
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/MohammadHijjawi97/since-cutoff
    rev: v0.5.0
    hooks:
      - id: since-cutoff-scan
        args: [--model=anthropic:claude-sonnet-4-5]  # 加上 --fail-on=old-form 可以阻止提交
      - id: since-cutoff-sync  # 让 AGENTS.md 中的说明保持最新;args: [--check] 只检查
since-cutoff-scan 在 lockfile、requirements 文件、conda environment.yml 或 pyproject.toml 变更时运行,并打印扫描结果;需要在 args 里给出 --model。since-cutoff-sync 在这些文件或 AGENTS.md、CLAUDE.md 变更时运行,并更新说明;如果它修改了文件,这个钩子就会失败,和其他会修改文件的 pre-commit 钩子一样:把文件加入暂存区后重新提交即可。使用 args: [--check] 时,它不修改任何内容,只要说明已过时就失败。它沿用说明写入时的模型;写第一个区块时,请给它指定一个:args: [--model=anthropic:claude-sonnet-4-5]。这两个钩子都要访问 PyPI,所以在 pre-commit.ci 上请跳过它们(ci: {skip: [since-cutoff-scan, since-cutoff-sync]})。since-cutoff-status 不需要联网:说明与 lockfile 不一致时它会失败。
配置 CI 时,可参考环境变量、文件和退出码参考(英文)。
# 适用于任何 CI 的 Markdown 摘要;你的代码以旧写法用到有变更的 API 时,退出码为 3
since-cutoff scan --model anthropic:claude-sonnet-4-5 --markdown summary.md --fail-on old-form

# AGENTS.md 中的说明已过时时退出码为 3,区块被手动修改过时为 4
since-cutoff sync --check

# 同时测试模型(需要对应的 API key,或 claude 命令行工具)
since-cutoff run --quick --fail-on-stale --json > since-cutoff.json
--markdown - 把摘要打印到标准输出,标准错误中只有进度和报告路径,与 --json 相同。输出到文件、管道或 CI 日志时不显示实时进度条,并按 160 列的宽度排版(可以用 COLUMNS 设置其他宽度)。退出码:
0正常;1出错(例如run没能探测任何 API 变更,或没有任何模型回答能被打分;或sync无法检查其说明所涉及的某个包);2用法错误;3检查未通过:scan --fail-on changes、used或old-form(有依赖在截止日期之后改了 API、你的代码用到了有变更的 API,或以旧写法用到它;--fail-on-changes等同于--fail-on changes),run --fail-on-stale(发现了过时的 API 用法),或sync --check、status发现说明已过时(以及sync没有写入时);4sync:区块被手动修改过,没有--force时不写入任何内容;141输出被提前关闭(例如通过管道传给了head)。
scan 和 sync 不需要模型:它们对比公开 API,找出你的代码在哪里用到了有变更的 API,并根据对比结果写出每个变更,附上表明检查了什么的标签(详情,英文)。run 分三个阶段。第一个阶段就是扫描,不需要模型;在另外两个阶段,每个回答都由类型检查器打分,模型写的每条说明也都由它检查:

| 结果 | 含义 |
|---|---|
| stale(过时) | 代码在对照版本(默认为模型截止日期至少 30 天之前发布的最新版本)上有效、在你的版本上无效,并且错误涉及一个有变更的 API |
| wrong(写错) | 对你的版本无效,但不能用变更来解释(臆造或误用了 API) |
| deprecated(已弃用) | 有效,但用到了在你的版本中标记为 @deprecated 的 API |
| correct(正确) | 对你的版本有效,并且确实用到了变更后的 API |
| untouched / off-task / invalid / error | 不计入任何比率,但始终会在报告中列出 |
从 0.3.0 起,留出任务的结果包括:无说明 -> 有说明时按任务计算的正确率(附上配对任务数和它们来自的 API 变更数);两者之差及其 95% bootstrap 置信区间(按 API 变更重抽样);说明修正了的变更数(无说明时错、有说明时对)及其 Wilson 95% 置信区间;说明弄坏了的变更数;修正与弄坏之间的精确符号检验;以及按原因列出的未计入的配对。回归检查报告模型原本答对的 API 在加入说明后有多少仍然正确。
run --compare template,signatures(0.3.0 及以后)还会用两种不需要模型的基线说明,回答同样的留出任务和回归检查:template 用一句话陈述每个失败的变更,内容取自 API 对比结果;signatures 给出每个变更 API(或其所在库指明的替代 API)的新签名和文档字符串的第一段。所有区块都在相同的配对上、对照相同的无说明回答打分,并显示每个区块的 token 数,所以一次运行就能看出 since-cutoff 自己写的说明比这些基线多带来了什么。
所有回答都由类型检查器针对确切的包版本打分,每个包都在各自独立的环境中检查,环境里装有该包自己的运行时依赖。没有 LLM 当评判,每个数字都能追溯到 results.json。详见 docs/how-it-works.md(英文)。
since-cutoff 从不单独使用“verified”(已验证)这个词。每条说明都带有一个标签,表明检查了什么,除此之外不作任何声明:
| 标签 | 检查了什么 | 没有检查什么 |
|---|---|---|
[diff] |
这个变更出现在对两个版本公开 API 的静态对比(griffe)中:默认在模型训练截止日期至少 30 天之前发布的最新版本,以及你的项目锁定的版本。源码只被读取,不被导入。只有 [diff] 时,说明不会给出任何替代项:它转述库自己的弃用说明中的话(“there is no replacement for resume_download”,没有替代项),或者给出该包的变更日志(其 PyPI 元数据中的 Changelog 链接,否则是它在 GitHub 上的 releases 页面)和锁定的版本,或者在 PyPI 两者都没有列出时,说明 since-cutoff 在那段文字中没有找到替代项。 |
行为,以及调用是否仍能运行:锁定的版本可能仍会接受一个已移除的参数并发出警告,比如 huggingface-hub 2.0.0 对 resume_download 就是这样。当锁定版本的源码仍会处理某个参数时,终端、report.md、MCP 工具和 JSON 会加上一行“Runtime:”;区块中不写,因为建议是一样的。你的模型是否会写错。 |
[diff + library] |
同 [diff],并且库自己的弃用说明(docstring、docstring 中某个参数的条目、@deprecated 消息或 warnings.warn 文本,来自旧版本;对于弃用,则来自锁定版本)明确给出了替代项(“Use stop instead”),而且这个名称在你锁定的版本中存在。只是作为建议提到某个名称的文字,会在 [diff] 下引用,不被当作替代项。 |
替代项的行为是否相同。 |
[diff + move checked] |
同 [diff],并且就能统计的方面而言,新路径上的对象就是同一个对象:类或模块至少保留了旧对象一半的公开名称,函数保留了它的参数,值保持不变。 |
行为。 |
[diff + metadata] |
旧版本的 Requires-Dist(其 wheel 的 METADATA)列出了一个锁定的版本不再列出的库,而公开 API 中原先用到该库类型的位置(参数、返回类型、属性、基类、重新导出)改为用到锁定的版本所依赖的另一个库的类型,或它自带的旧库副本的类型,旧库的类型一个也没有留下:openai 3.x、anthropic 1.8、huggingface-hub 2.0 和 mcp 2.2 在原先接受 httpx 对象的地方改为接受 httpx2 对象。单独的 [metadata] 标记的是你的代码导入的、在截止日期之后(或截止日期前的余量天数内)才首次发布的包的那一条说明:没有任何版本可以对比,所以说明给出它首次发布的日期、它在 PyPI 上的简介和它的变更日志链接。 |
行为:锁定的版本是否仍接受旧库的对象(根据各自的源码,openai 3 会转换其中一部分,anthropic 1.8 会抛出 TypeError)。终端、report.md、MCP 工具和 JSON 会加上一行“Installed:”(你的项目,包括其虚拟环境,是否仍有旧库)和一行“Runtime:”,指出锁定版本的源码在哪里仍提到它。 |
[diff; probable rename] |
位置相同、类型注解相同的参数换了新名字,且锁定版本 docstring 中的版本说明(.. versionadded::、.. versionchanged::)没有说新参数是新增的或旧参数已被移除。这是推测,并标明为推测。 |
它是否就是同一个参数。 |
[type-checked] |
由模型在 since-cutoff run 中写出,因为它的示例通过了下面的类型检查而被保留。 |
行为;这条说明的解释在它展示的名称之外是否也正确。 |
[not confirmed] |
仅在使用 sync --suggestions 时出现:锁定版本中与被移除内容相似的名称(这时说明条目的标签写作 [diff; not confirmed])。 |
其中任何一个能替代它。 |
标签可以组合:各项依据用 + 连接([diff + library]),推测写在 ; 之后([diff; probable rename]、[diff; not confirmed])。
只是看起来相似的名称,默认从不写进说明。终端、report.md 和 MCP 工具把它们显示为“not confirmed as replacements”(未确认为替代项),当库表示没有替代项时则完全不显示;sync --suggestions 会加上它们,并标为 [not confirmed]。
[type-checked] 背后的类型检查。 模型写的说明只有同时满足以下所有条件才会被保留(模型有两次机会):
- 它的完整示例可以解析,并且导入了这个包;
- basedpyright(standard 模式,弃用按错误报告,移除
# type: ignore和# pyright:注释)针对你 lockfile 中确切版本的源码及该版本的运行时依赖(在一个除此之外为空的环境中)检查示例时,没有报告任何归属于该包的错误,也没有报告该包的任何弃用; - 说明中用反引号括起来的每个库名称,都出现在这个示例中,或出现在这条说明所对应的 API 对比条目中;
- 说明不超过 60 个词。
所以 [type-checked] 表示示例用到的导入、名称、参数和参数个数在你的版本中存在,并且没有被标记为 @deprecated(PEP 702)。包以外的错误(标准库、其他库)不会阻止一条说明。它并不表示代码在运行时行为正确,不表示替代项就是维护者推荐的那个,也不表示这条说明对模型有帮助。一条说明没有通过检查时,since-cutoff 会改为写入根据 API 对比结果得出的说明,并附上它的标签。
测量是另一回事:since-cutoff run 在无说明和有说明的情况下分别回答留出任务,并报告计数。since-cutoff 中没有其他任何东西会说明一条说明是否有帮助。
在 run 中,一个回答算作正确的条件是:它导入了这个包,用到了有变更的 API,并且在你的版本上没有归属于该包的“知识”错误(未知的名称、导入或参数;缺少必需参数;参数个数错误)。纯粹的类型严格性问题会被忽略。不会运行任何回答。
AGENTS.md 中的区块包含带标签的说明条目,以及每个包的说明所适用的版本和对照版本。其余信息在 scan --json 和 results.json 中:used_apis[](你的代码用到的每个有变更 API、用到的位置、它的变更、它的替代项及来源,以及它的说明,含 tags、applies_to 和 checks),以及 run 之后的 notes_detail[](每条说明,包括模型写的示例和留出任务测试测得的结果;verified 仍然保留,含义与 checks.example_type_checks 相同)。
参考文档(英文)列出了它读取的环境变量,以及它读取和写入的文件。
- 不运行任何包代码,也不运行模型写的代码。 包只做静态读取(griffe 关闭 inspection;只解压
.py/.pyi文件,并检查路径和大小)。模型的回答只在本地用 basedpyright 做类型检查。 - 获取:从 PyPI 获取公开的包元数据和 wheel,从 models.dev 获取模型的训练截止日期(内置快照,可离线使用)。Git、本地路径、workspace 和私有源中的依赖,绝不会按名称去公共 PyPI 上查找。
status不获取任何内容。 - 发送:只有
run会发送提示词,并且只发给你选择的模型服务商,内容包括包名、版本、变更 API 的公开签名和文档字符串、生成的任务,以及(用于写说明的)模型自己的回答。从不包含你的源代码。scan、sync、status、MCP 服务器、GitHub Action 和 pre-commit 钩子不向任何模型发送任何内容。 - 显示你的代码在哪里用到了有变更的 API(目前是文件名):显示在终端和
.since-cutoff/中,不会发送到任何地方。是否传出由你决定:--markdown和--annotate github会把它写进 CI 任务的摘要和注解,MCP 工具project_changes会把它返回给调用它的 Agent,而 Agent 会把工具结果传给它所用的模型。 - 保存:结果保存在项目中的
.since-cutoff/目录(该目录会自动被 git 忽略)和一个本地缓存里:since-cutoff cache info显示缓存位置和各类内容的大小,since-cutoff cache clear清除缓存,加上--sources、--diffs或--pypi则只清除该类(run得到的模型回答要花钱才能重新生成,会被保留)。解压出的包源码占缓存的大部分,上限为 2 GB(SINCE_CUTOFF_CACHE_MAX_MB;0 表示不设上限):解压新版本后,最久未使用的源码会被删除,但正在运行的扫描所用的绝不会删除;一次运行中的第一次删除会打印一行,说明删除了多少。sync(在你同意后,或使用--yes时)和run --apply会在 AGENTS.md 或 CLAUDE.md 中写入一个带标记的区块,文件其余部分逐字节保持不变;since-cutoff unapply可以移除这个区块。 - 没有遥测,不需要账号,不收集个人数据。重复运行直接读取缓存,所以不花钱,结果也可复现(
--fresh会重新询问模型)。详见 PRIVACY.md(英文)。
- 目前仅支持 Python。下一步是 TypeScript(
.d.ts对比、tsc)(#1)。 - 类型检查器能发现错误的名称、错误的参数和 PEP 702 弃用,但看不到签名不变而行为改变的情况,也看不到只在运行时发出警告的弃用。
scan还会列出用库自己的装饰器(名称包含 "deprecat")声明的弃用,以及已被移除、但模块仍通过__getattr__提供并发出警告的名称;不过run不会探测这些弃用。 - 对比只覆盖公开 API:
_private名称,以及包内自带的测试、基准测试和示例,都会被跳过。 - “Your code uses”(你的代码用到了)是逐个文件的静态匹配:导入(包括重新导出的名称)、调用、属性读取和关键字参数;方法调用的接收者会根据包自身的注解确定类型(
df = pd.read_csv(...)是一个DataFrame;一个类连同它的基类一起计入,跨越你锁定的各个包)。它不追踪getattr这类动态访问,目前只指出文件,不指出行号(#8)。在代码没有显示其类的值上读取的方法,可以只按名称计入:这个名称仅属于一个有变更的 API,既不是常见名称,也不是内置类型或标准库类型的成员。除非给出--include-name-matches(通过 MCP 时为include_name_matches),这种[name match]不会出现在任何报告、说明、--fail-on和--annotate中,因为它们大多是另一个库中同名的方法。变为必需、仅限关键字或仅限位置的参数,目前总是显示为“uses this API”,从不显示为“old form”。 - 只有当库自己的弃用说明明确给出替代项时,说明才会写出替代项。只出现在迁移指南里的建议(anthropic 的 MIGRATION.md 建议对仍接受
temperature的旧模型使用extra_body)不会出现在说明中。 - 探测的是破坏性变更中按优先级排序的一个样本(你的代码已经用到的符号优先),而不是全部。
- “对照版本”指在截止日期至少 30 天之前发布的最新版本(
--cutoff-margin;0表示从截止日期当天算起)。模型对截止日期前几周的了解最少,所以实际的过时可能开始得更早;这个余量只是对“早多少”的一个估计。 - 留出任务是针对同一个变更的改写:它们能说明一条说明修正了这个变更,不能说明模型整体变强了。
截止日期只用来选定一个对照点,并不代表模型记住了什么。since-cutoff 从 models.dev 获取这个日期(或使用 --cutoff);只写到月份时指该月的最后一天(2025-07 即 2025 年 7 月 31 日)。它把这个日期往前推一个余量(--cutoff-margin,默认 30 天),再对每个依赖取在得到的那一天或之前上传的最新正式版本(跳过被撤回(yanked)的版本;只有当这个包到那时还没有任何正式版本时才用预发布版本,从不使用开发版本),再把这个版本的公开 API 与你锁定的版本做对比。对比结果是一份候选清单:模型的训练数据大概率不包含的 API 变更。
这个对照日期决定三件事:
- 哪些包需要对比:锁定版本不比对照版本新的包没有可对比的内容;在这个日期之后才首次发布的包会被列为新包;
- 在
run中,对照版本一侧做类型检查时,该版本自身的依赖取哪些版本(每个依赖要求在那一天允许的最新版本); run中每次探测的“旧”一侧:一个回答如果在对照版本上有效、在你的版本上无效,并且错误落在有变更的 API 上,就记为“过时”(stale),而不是“写错”(wrong)。
模型可能了解其标称截止日期之后的某个版本,也可能不了解截止日期前不久的版本,所以扫描结果可能列出模型其实已经能处理的变更,也可能漏掉一些它处理不了的变更。余量针对的是后一种情况;--cutoff-margin 0 从截止日期当天算起。模型是否真的会写出旧 API,只有 run 能说明:它在不给工具、只告诉模型项目锁定了哪个版本的情况下直接询问模型。
since-cutoff 针对一个项目回答一个问题:从模型训练截止日期所对应的版本到你锁定的版本,哪些公开 API 发生了变化(你的代码用到的排在最前)?since-cutoff run 另外回答两个可选的问题:这个模型是否真的会写错它们?一条简短的说明能否纠正?下表中的大多数工具回答的是另一个问题(“这个库的文档现在怎么说?”),可以和 since-cutoff 很好地配合使用。
| 工具 | 做什么 | since-cutoff 与之的关系 |
|---|---|---|
Context7(MCP 服务器和 ctx7 命令行工具) |
Agent 在工作时调用 resolve-library-id 和 query-docs,把文档片段拉进上下文。如果库的所有者添加了某个版本(git tag 或分支,最多 20 个),它就提供该版本的文档(/org/project/version);否则提供已索引分支的文档。不用 API key 也能用,但匿名调用的速率限制更低。 |
互补。Context7 提供文档;它不读取你锁定的版本,也不检查 Agent 写出的代码。since-cutoff 列出你锁定的 API 中哪些在模型截止日期之后变了(你的代码用到的排在最前),让你知道哪里需要查文档或写说明。向 Context7 提问时,请写明你锁定的版本。 |
| 其他文档服务:Ref、docs-mcp-server | 在回答当下为 Agent 提供文档搜索;docs-mcp-server 可以在本地索引文档 | 与 Context7 相同。 |
| library-skills | FastAPI、Streamlit 等库在包内附带 Agent 技能;uvx library-skills 把你已安装版本的技能链接到 .agents/skills 或 .claude/skills,因此技能会随库一起更新 |
由维护者编写,并与你安装的版本同步:库提供了技能就用它。since-cutoff 覆盖没有提供任何指引的包,而且只陈述 API 层面的变更。 |
| 厂商的技能插件,例如 pydantic/skills | 面向 Claude Code、Codex 和 Cursor 的插件,以及 Pydantic、Pydantic AI 和 Logfire 的 SKILL.md 文件,从仓库安装 |
维护者关于如何用好一个库的指引;随插件仓库发布,而不是随你锁定的版本发布。since-cutoff 的说明是针对你的 lockfile 写的。 |
代码改写工具(codemod):ast-grep 规则、OpenAI 的 openai migrate(Grit) |
用手写的语法规则改写已有代码;ast-grep 的规则目录里有一个 OpenAI SDK 迁移(把 openai.Completion.create(...) 改成 client.completions.create(...)) |
迁移已有代码时,codemod 是合适的工具。since-cutoff 关注的是助手接下来要写的代码:它从 API 对比结果而不是从别人写的规则中找出变更,而且只给建议,不改写任何代码。 |
| 依赖更新机器人:Renovate、Dependabot | 创建更新锁定版本的 pull request | GitHub Action 可以在这些 pull request 上运行,列出你的代码用到的有变更 API 以及用到它们的文件,并且在设置 check-notes 时,在说明同步之前让任务失败。 |
| 基准测试:GitChameleon 2.0、VersiCode、CodeUpdateArena、LibEvolutionEval | 在固定的任务集上衡量模型,任务取自真实的版本变更,或是合成的(CodeUpdateArena);GitChameleon 2.0 会运行单元测试 | 它们对模型做总体比较,其中一些通过运行测试来检查行为。since-cutoff 只看一个项目锁定的版本,而且是静态检查:类型检查器能看到名称、参数和弃用标记,看不到行为。 |
since-cutoff run 的 --compare signatures 会把新版本的签名和文档字符串的第一段交给模型。它是文档查询在本地的替代做法,不是 Context7。
另外两个较小的工具也在解决同一个问题:cutoff 面向库的维护者,让模型写程序,并在库的当前版本上运行这些程序来做检测;postcut 把 Ruby 的 Gemfile.lock 转换成一份截止日期之后的变更简报。since-cutoff 基于 griffe、basedpyright、models.dev 和 rich 构建。
since-cutoff scan 告诉你该查哪些 API;Context7 可以提供文档。提问时写明你锁定的版本(例如“anthropic 1.8.0”)。只有当库的所有者添加了该版本时,Context7 才能匹配到它:2026-09-27 当天,/openai/openai-python 提供 v1.68.0、v1_105_0、v2.8.1 和 v2.11.0,而 /anthropics/anthropic-sdk-python 一个版本都没有,所以你拿到的可能是默认分支的文档。
- 代码补全中的弃用 API。 Wang 等,LLMs Meet Library Evolution: Evaluating Deprecated API Usage in LLM-based Code Completion(ICSE 2025;arXiv:2406.09834,最初的标题是 How and Why LLMs Use Deprecated APIs in Code Completion? An Empirical Study)。7 个模型,来自 8 个 Python 库的 145 组“弃用 API → 替代 API”映射,28,125 个补全提示。大多数补全两个 API 都没有用到。在用到其中之一的补全中(论文称之为“plausible”补全),就整个数据集而言有 25-38% 用的是弃用 API:提示取自使用弃用 API 的代码时为 70-90%,取自已更新代码时为 9-18%。论文在“模型用了弃用 API 的已更新代码提示”上测试了两种基线修复方法。ReplaceAPI 在解码时把弃用 API 的 token 换成替代 API,再让模型补完这一行:在六个开源模型上,之后有 85.2-99.6% 的情况用上了替代 API(它需要控制解码过程,所以不能用于 GPT-3.5)。InsertPrompt 插入注释
# {dep} is deprecated, use {rep} instead and revise the return value and arguments.后重新生成:视模型不同为 25.7-97.2%,作者认为它的效果和准确性都还不够。since-cutoff 的说明接近 InsertPrompt,只是放进了项目的指令文件;since-cutoff run会在留出任务上测量它们,而不是假定它们有效。 - 只把文档放进上下文还不够。 Ashik 等,When LLMs Lag Behind: Knowledge Conflicts from Evolving APIs in Code Generation(arXiv:2604.09515,2026 年预印本)。270 个真实的 API 更新(45 个弃用或移除、128 个修改、97 个新增),来自 8 个 Python 库在 2023 年 12 月之后发布的版本;11 个模型来自 4 个系列,训练截止日期都在这个日期之前。只给出更新说明时,模型在 74.64% 的回答中至少部分采用了更新(由 GPT-5 mini 判定),这些回答中有 42.55% 能在引入该更新的库版本中运行;再加上 API 文档后,92.87% 采用了更新,66.36% 能运行。再加入思维链(chain-of-thought)和自我反思(self-reflection)提示,可运行率又提高了 11.33%(这是相对提升,不是百分点)。在没有采用更新的回答中,42.1% 完全忽略了更新,16.4% 用了旧 API;在最佳设置下仍无法运行的已采用回答中,与更新相关的最常见原因是参数错误(占这些失败的 26.6%)。这正是 since-cutoff 要针对你的确切版本检查代码、并用
since-cutoff run带着说明重新测试模型、而不是假定模型会遵循说明的原因。 - 基准测试。 GitChameleon 2.0:328 个 Python 补全问题,每个都绑定特定的库版本,并用可执行的单元测试检查;企业模型的基线成功率为 48-51%,检索文档最多提高约 10 个百分点(GPT-4.1:从 48.5% 到 58.5%),自我调试(self-debugging)提高约 10-20 个百分点。VersiCode:特定版本的代码补全和感知版本的代码迁移,覆盖 300 多个 Python 库、9 年间的 2,000 多个版本。CodeUpdateArena:针对 7 个 Python 包中 54 个函数的知识编辑,更新是由 GPT-4 生成的合成更新,共 670 个程序合成示例;把更新的文档放在前面,并不能让开源模型(DeepSeek、CodeLlama)用上它。LibEvolutionEval(NAACL 2025):覆盖 8 个库的特定版本行内补全;检索特定版本的文档和提示方法都有帮助。
这些研究在固定的任务集上衡量许多模型;GitChameleon 2.0 和 Ashik 等会运行生成的代码。since-cutoff 做的事情更窄:针对一个项目,它列出自对照版本以来的变更(你的代码用到的排在最前),run 则静态检查一个模型的回答。它看不到签名不变而行为改变的情况,而运行代码的测试可以看到。
since-cutoff 还很年轻。目前最有帮助的是:
- 在你的项目上运行它,把发现的结果(包括误报)发到 Share your results。
- 认领一个 good first issue:小而独立的任务,比如支持另一种 lockfile 格式,或添加一个模型服务商预设。
- 更大的工作标记为 help wanted,例如 TypeScript 支持。
- 报告 bug 或奇怪的结果:请提交到 Issues。
CONTRIBUTING.md(英文)介绍了代码结构和需要通过的检查;离线测试套件用一个玩具库和一个脚本化的模型跑通整个流程,不需要 API key。安全问题请见 SECURITY.md(英文)。
如果你在研究中使用了 since-cutoff,请引用它(见 CITATION.cff)。
MIT © Mohammad Hijjawi